过去二十年,互联网解决了一个巨大的问题:
信息分发。
搜索引擎让信息可以被找到。
社交平台让普通人第一次获得了大规模传播能力。
电商平台让企业可以直接触达消费者。
我们拥有的数字工具越来越多。
生产的数字内容越来越多。
积累的数字资产也越来越多。
但与此同时,一个相反的趋势也在发生:
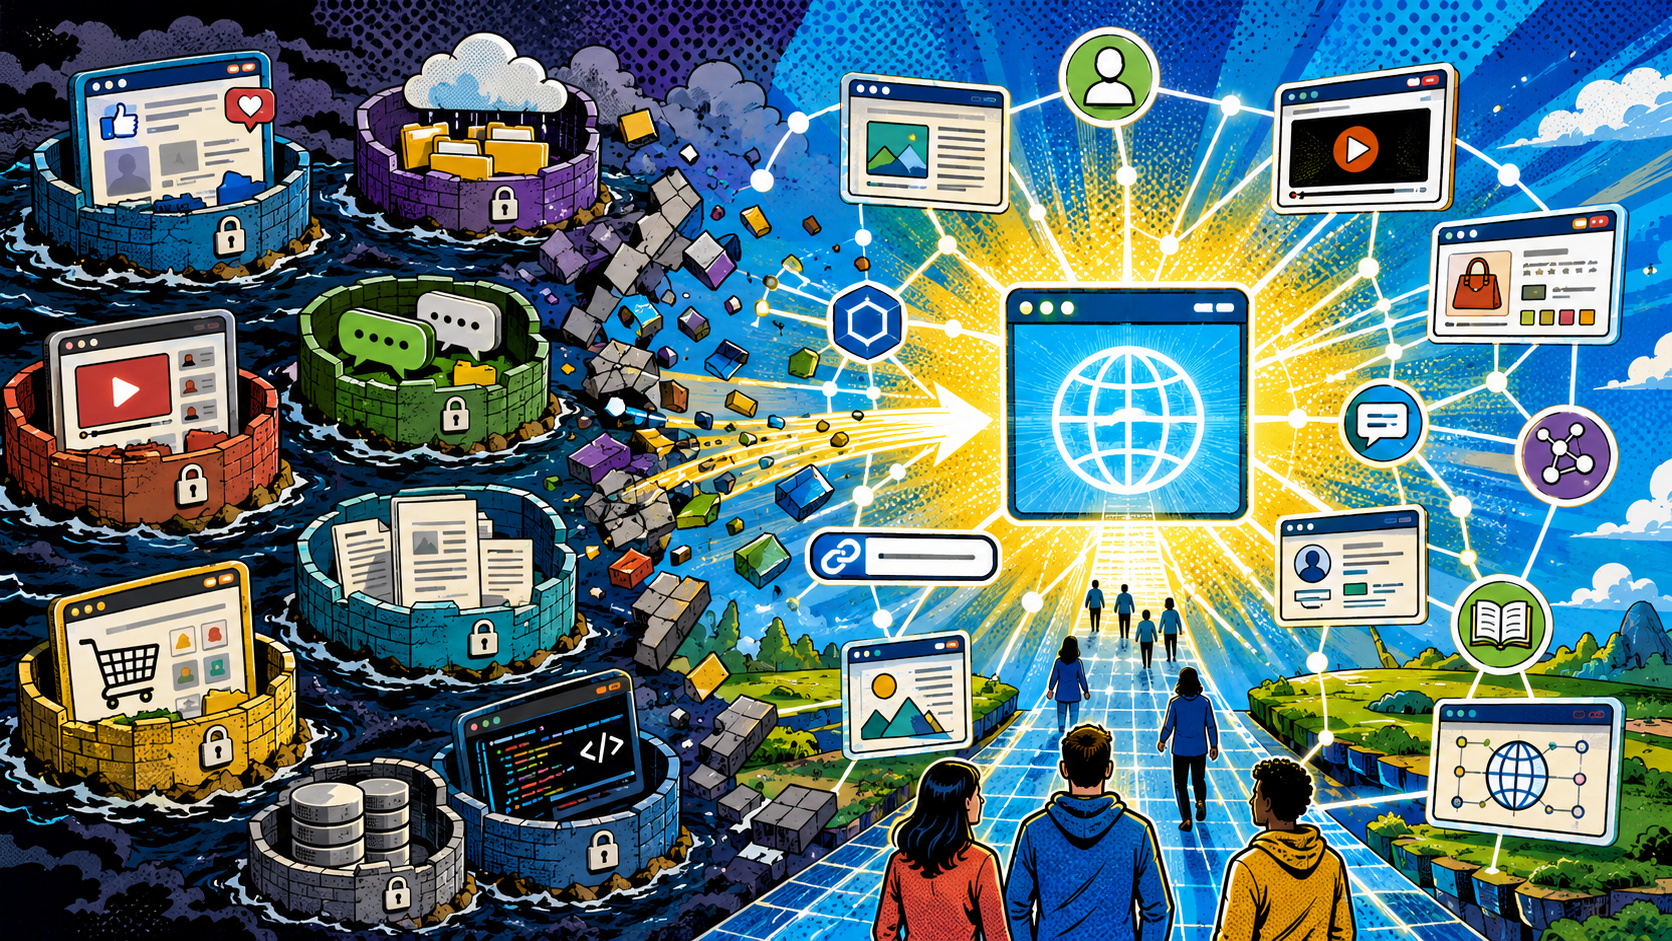
互联网连接的信息越来越多,个人和企业自己的数字资产却越来越碎。
文章在公众号。
视频在短视频平台。
商品在电商平台。
设计文件在云盘。
数据散落在不同 SaaS。
知识躺在 Word、PDF、Notion 和企业内部系统里。
用户关系则分布在不同账号和平台之中。
每一个系统都解决了一个具体问题。
但所有系统加在一起,却形成了越来越多彼此割裂的:
信息孤岛。
我们可能拥有很多数字资产,却没有真正拥有一个完整、可连接的数字世界。
从开放 Web,到一个个封闭的数字空间
Web 最初一个非常重要的设计思想,就是:
连接。
一个页面可以链接另一个页面,一个网站可以引用另一个网站,
一篇文章拥有自己的 URL,一个组织拥有自己的域名,
搜索引擎可以跨越不同网站发现和索引信息,
用户可以沿着链接,从一个节点走向另一个节点,
互联网因此成为一张真正意义上的:
Web。
Web 的价值并不仅仅在于“有很多网站”,
更重要的是:
每一个信息节点都可以拥有独立地址,并与其他节点建立连接。
但平台时代改变了这种结构。
越来越多的信息不再首先出生于 Web,而是出生于某个平台内部。
内容在平台里发布,用户在平台里关注,商品在平台里销售,关系在平台里建立,推荐在平台内部完成,甚至搜索本身,也越来越多地发生在不同平台内部。
于是互联网逐渐从一张开放的 Web,变成了:
许多个彼此相邻,却并不真正互联的巨大数字空间。
我们仍然在使用互联网,
但很多时候,我们是在一个个 App 内部使用互联网,
进入一个平台,重新搜索一次;
进入另一个平台,再重新建立一套身份、关系和内容体系。
互联网依然存在。
只是越来越多数字活动被包裹进了不同的封闭生态。
平台解决了效率,也制造了新的边界
平台本身创造了巨大的价值。
如果没有成熟平台,一个品牌想触达数百万消费者,需要自己建设非常复杂的传播、支付、交易和用户系统。
今天,企业可以直接进入成熟生态。
创作者可以注册一个账号立即开始发布内容。
商家可以通过电商平台获得支付、物流、评价和流量。
这是效率的巨大提升。
但平台也天然拥有另一种倾向:
尽可能让内容留在自己的系统中,
让用户留在自己的系统中,
让关系留在自己的系统中,
让交易留在自己的系统中,
让更多行为在内部完成。
从平台商业逻辑来看,这并不难理解。
用户停留越久,内部行为越多,生态价值越高。
问题出现在另一边:
当个人和企业为了获得平台效率,把数字资产本身也一起交给平台承载时,渠道和资产开始混在一起。
原本应该负责传播的地方,开始同时承担:
内容原点、用户关系、品牌身份、
商品信息、商业交易、甚至一个人或企业在互联网上最主要的存在方式。
这时候真正的问题已经不只是:
“某个平台今天给不给流量。”
而是:
我们的数字世界,是不是已经建立在别人定义的连接规则之上?
一个链接为什么如此重要
链接可能是互联网中最普通的技术之一。
但链接背后代表的是一种非常重要的能力:
连接权。
我有一篇文章,
可以链接到自己的产品,
产品可以链接到使用文档,
文档可以链接到研究,
研究可以引用其他来源,
用户可以沿着这些关系自由移动。
一个数字资产由此不再是一个孤立对象,而开始进入一张更大的网络。
这正是 Web 最基本的力量之一。
但当外部链接、跳转、引用、迁移和重新组织不断受到限制时,真正受到影响的不只是一次营销行为。
更深层的问题是:
数字资产之间建立关系的能力正在减弱。
一个平台内部可以拥有海量内容。
但如果这些内容难以被外部发现、引用、连接和重新组合,那么它仍然可以形成一个巨大的信息孤岛。
信息很多,连接却有限。
这与 Web 最初的基本结构几乎正好相反。
数字资产需要重新拥有自己的原点
如果一个重要数字资产只存在于某个平台内部,那么这个平台实际上就是它事实上的存在环境。
如果一篇文章只有公众号版本,那么它依赖公众号存在。
如果一款产品只有电商平台商品页,那么平台页面就成为它最主要的数字身份。
如果一个品牌只存在于几个社交媒体账号中,那么品牌在数字世界中的存在,同样受到这些账号结构的约束。
因此,一个越来越重要的问题是:
数字资产有没有自己的独立原点?
可以把这个原点理解为:Web Origin。
它不是简单地“多备份一份”,
而是让重要数字资产拥有:
稳定地址、明确身份、长期来源、
开放连接、可以被发现、可以被引用、
可以被机器识别、并且不依赖某一个内容平台才能证明自己的存在。
例如:
一篇重要研究拥有自己的永久页面。
一款产品拥有自己的官方页面和文档。
一个品牌拥有自己的域名和组织身份。
一套知识拥有长期、结构化的 Web 表达。
这时候平台中的版本不再是唯一存在。
它们开始变成:传播版本。
原件与副本应该重新被区分
今天很多人已经开始做多平台运营。
一篇内容发公众号,发知乎,发微博,再做成短视频,
这确实降低了对单个平台的依赖。
但如果每一份内容都分别出生于不同平台,那么它们本质上仍然是:
多个孤岛中的多个副本。
另一种结构则不同:
首先建立一个明确的原始来源。
然后根据不同媒介和平台重新表达。
例如:
Web 原文
→ 公众号长文
→ 知乎版本
→ 微博摘要
→ 短视频口播
→ 长视频讨论
这样就出现了一个非常重要的概念:Canonical Source。
也就是:
唯一、稳定、长期的原始来源。
其他平台不再承担“保存原件”的责任,平台只负责传播。
可以概括成一句话:建立一次,到处传播。
平台越多,传播能力越强。
但数字资产的原点仍然存在。
把数字资产带回 Web,不等于把所有业务搬回网站
“回归 Web”很容易被误解成另一种极端:
所有内容都只能发网站,
所有交易都必须在官网发生,
所有用户都必须离开平台,
这显然不现实。
平台依然拥有极高的分发效率。
企业完全可以把主要营销预算集中在某个平台,
商家也完全可以主要依赖成熟电商平台成交,
创作者同样可以继续把短视频平台作为重要流量入口,
真正需要区分的是两件事:
业务发生在哪里。
和:
资产的原点在哪里。
一家企业可以让 90% 的销售发生在某个平台,
但品牌身份不需要因此完全属于那个平台。
一名创作者可以让 90% 的流量来自短视频,
但原创内容、方法论和长期知识不需要因此只存在于短视频平台。
所以更准确的关系不是:
Web 替代平台。
而是:
Web 负责拥有,平台负责分发。
两者可以同时存在,甚至应该同时存在。
AI正在重新提高 Web 的价值
过去谈 Web,很多时候讨论的是浏览器和搜索引擎。
但 AI 正在改变信息发现的方式,
越来越多用户不再首先进入一个网站寻找答案。
而是直接提出问题:
这家公司做什么?
这个产品有什么区别?
某个概念是什么意思?
应该如何解决某个问题?
谁研究过这个问题?
AI随后需要寻找、理解和组织大量外部信息。
这时候,一个新的基础问题出现了:
机器从哪里获得稳定、可靠的原始信息?
如果企业的数字资产全部散落在不同平台、内部文件和封闭数据库中,那么机器最终看到的很可能只是碎片。
但如果企业拥有:
明确的域名、稳定的页面、清晰的组织身份、
结构化产品信息、公开文档、知识库、
FAQ、研究材料、长期 URL,
那么这些资产不仅更容易被人发现,也更容易成为机器理解世界的信息来源。
因此,未来 Web 的重要性未必表现为:
所有人重新每天打开几十个网站。
更可能表现为:
Web重新成为搜索、AI 和 Agent 获取原始信息的重要基础设施。
用户第一次认识一个品牌,可能仍然来自短视频。
用户看到最终答案的地方,可能是 AI。
用户完成交易的地方,可能是某个 App。
但支撑这些系统理解:
“你是谁?”
“你有什么?”
“你说过什么?”
“你的产品是什么?”
这些基础信息,可以重新来自开放 Web。
从 Ranking,到 Recommendation,再到 Source
互联网的信息竞争已经发生过几次明显变化。
搜索时代,人们争夺:Ranking,谁排在搜索结果前面。
平台时代,人们争夺:Recommendation,谁进入推荐流。
AI时代还可能增加一个越来越重要的位置:
Source,谁成为答案背后的原始来源。
这意味着数字资产建设的目标也可能发生变化。
过去建设网站,主要为了让人访问。
未来建设 Web,还可能为了:
让机器知道这项信息来自哪里。
当大量答案开始被 AI 重新组织之后,“来源”本身可能成为一种新的数字资产。
不是只争夺一次点击,而是争夺:Source Authority,来源权威。
很多数字资产其实还没有真正进入 Web
企业可能已经拥有大量有价值的信息:
研究报告、产品资料、技术文档、数据、案例、
FAQ、课程、视频、内部方法论、行业知识、
客户问题、历史经验,但它们可能只是存在于:
Word、PDF、Excel、云盘、NAS、聊天记录、
内部知识库、员工电脑,这些当然是数字文件。
却不一定已经成为真正意义上的:Web Asset(WEB资产)
两者之间存在明显区别。
一个文件可以被保存,一个 Web Asset 则可以进一步拥有:
独立身份、永久地址、开放连接、明确来源、
机器可读性、搜索发现能力、引用关系、长期积累能力。
所以真正的“Web 化”不是:
把 PDF 上传到服务器。
而是让数字资产开始成为互联网中的一个:节点。
从文件,到节点
一份研究报告如果只是一份 PDF,它首先是一个文件。
如果它进一步拥有:
一个永久页面、明确作者、发布时间、相关研究、
引用关系、结构化信息、可索引内容、稳定 URL,
那么它就开始成为 Web 中的一个节点,
其他页面可以链接它,搜索可以发现它,AI可以识别它,后续研究可以引用它。
用户几年以后仍然能够重新找到它,这一变化看似只是技术形式变化,背后却意味着:
数字资产第一次进入了一个更大的连接网络。
从:
File(文件)变成Node(节点)。
从Storage(存储)变成 Network(网络)。
这可能是“数字资产回到 Web”真正发生的地方。
Web应该重新成为数字资产层
如果把未来的信息体系简单分层,可以形成一种非常清晰的关系。
Web:资产层负责:
身份、内容、知识、产品、原始信息、长期来源。
Platform:分发层负责:
推荐、传播、互动、交易效率。
Search / AI:发现与理解层负责:
寻找、索引、理解、组织、回答。
Application:行动层负责:
购买、使用、支付、服务、具体业务操作。
在这样的结构里,平台依然重要,AI也会越来越重要。
App依然会提供最好的具体体验。
但个人和企业不再需要把自己的全部数字存在寄托于其中任何一层,因为最底层依然存在一个:
独立的 Web Origin。
对抗平台,真正对抗的是信息封闭
因此,“回归 Web”天然带有一种对平台封闭生态的对抗性。
但这种对抗并不意味着否定平台,平台有权建立自己的规则,平台也有权优化自己的商业模式,企业和创作者同样有权选择:
不把自己创造的全部数字资产永久锁定在任何一个平台内部。
真正需要对抗的是:
数字身份的单点控制、内容的单点存放、关系的单点承载。
以及:连接能力的单点控制。
开放 Web 提供的另一种可能是:
即使某一个平台发生变化,数字资产仍然存在,身份仍然存在,原始内容仍然存在,知识仍然可以被找到,其他系统仍然可以连接它。
这才是真正重要的选择权。
下一阶段,互联网可能重新需要“连接”
过去二十年,互联网最成功的创新之一,是解决了信息分发。
平台让信息能够快速到达用户,算法极大提高了分发效率。
但当信息越来越多地进入彼此隔离的生态以后,一个更加基础的问题可能重新出现:
如何重新连接这些信息?
AI的出现进一步放大了这个问题。
因为机器想要理解世界,首先需要找到世界。
而如果整个数字世界被切成一个个封闭数据库,那么机器面对的同样只是无数碎片。
开放 Web 的价值因此可能重新出现,不是因为我们怀念过去的互联网,而是因为下一代信息基础设施仍然需要:
稳定身份、开放地址、来源、链接、引用、连接。
这些恰恰是 Web 最擅长提供的东西。
结语
互联网原本是一张 Web。
后来,我们在这张 Web 上建设了越来越多巨大的平台。
平台解决了分发,SaaS解决了效率,App解决了体验,
这些都是数字经济的重要进步。
但与此同时,我们也把大量身份、内容、知识、关系和商业价值切割进了不同的信息孤岛。
下一阶段,也许不需要再建设一个更大的孤岛。
真正值得重新解决的,反而是互联网最古老的问题:连接。
让品牌拥有自己的数字身份,
让内容拥有自己的原始来源,
让知识拥有自己的永久地址,
让产品拥有自己的官方表达,
让搜索和 AI 能够找到它们,
让平台重新成为渠道,而不是数字资产唯一的家。
把数字资产重新带回 Web,并不是互联网的一次倒退,
恰恰相反,当 AI 开始重新理解、组织和连接整个互联网时,我们可能比任何时候都更需要一个:
开放、可连接、可引用、可机器理解的 Web。
所以真正的问题也许不是:
我们应该离开哪个平台?
而是:
我们创造的数字价值,是否拥有一个不依赖任何单一平台也能够继续存在的地方?
结束信息孤岛,把数字资产重新带回 Web。